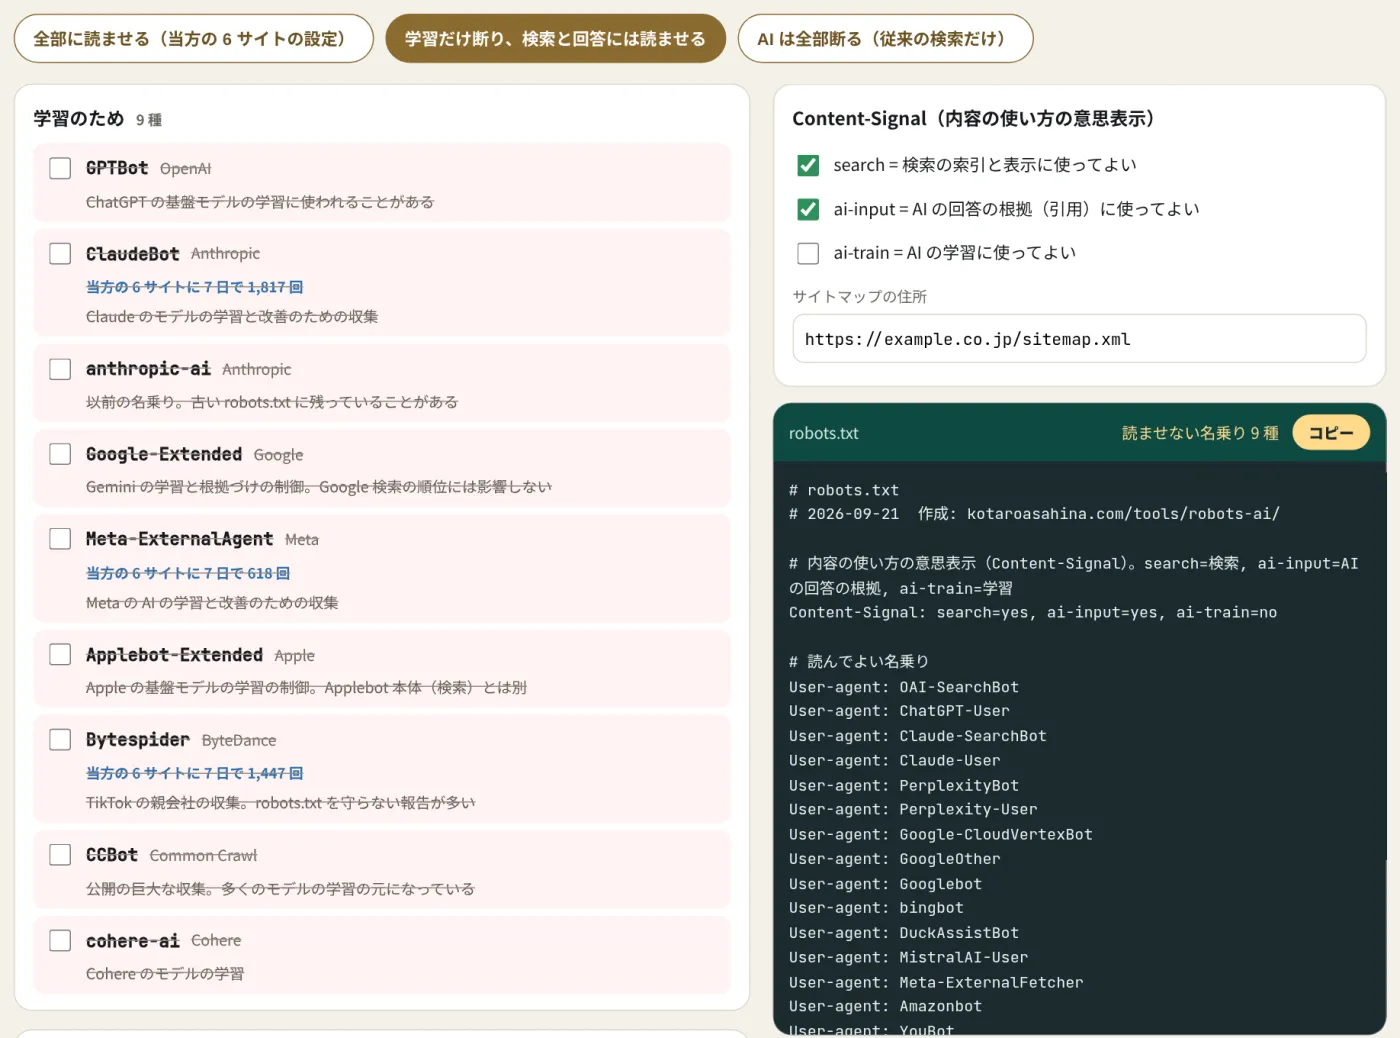
GPTBotOpenAI
学習のため。ChatGPT の基盤モデルの学習に使われることがある。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: GPTBot
Disallow: /
無料の道具・端末内で動く・何も送信しない
27 種の AI クローラーを「何のために来るか」で分け、押すだけで robots.txt を作ります。内容の使い方の意思表示(Content-Signal)も一行で入ります。
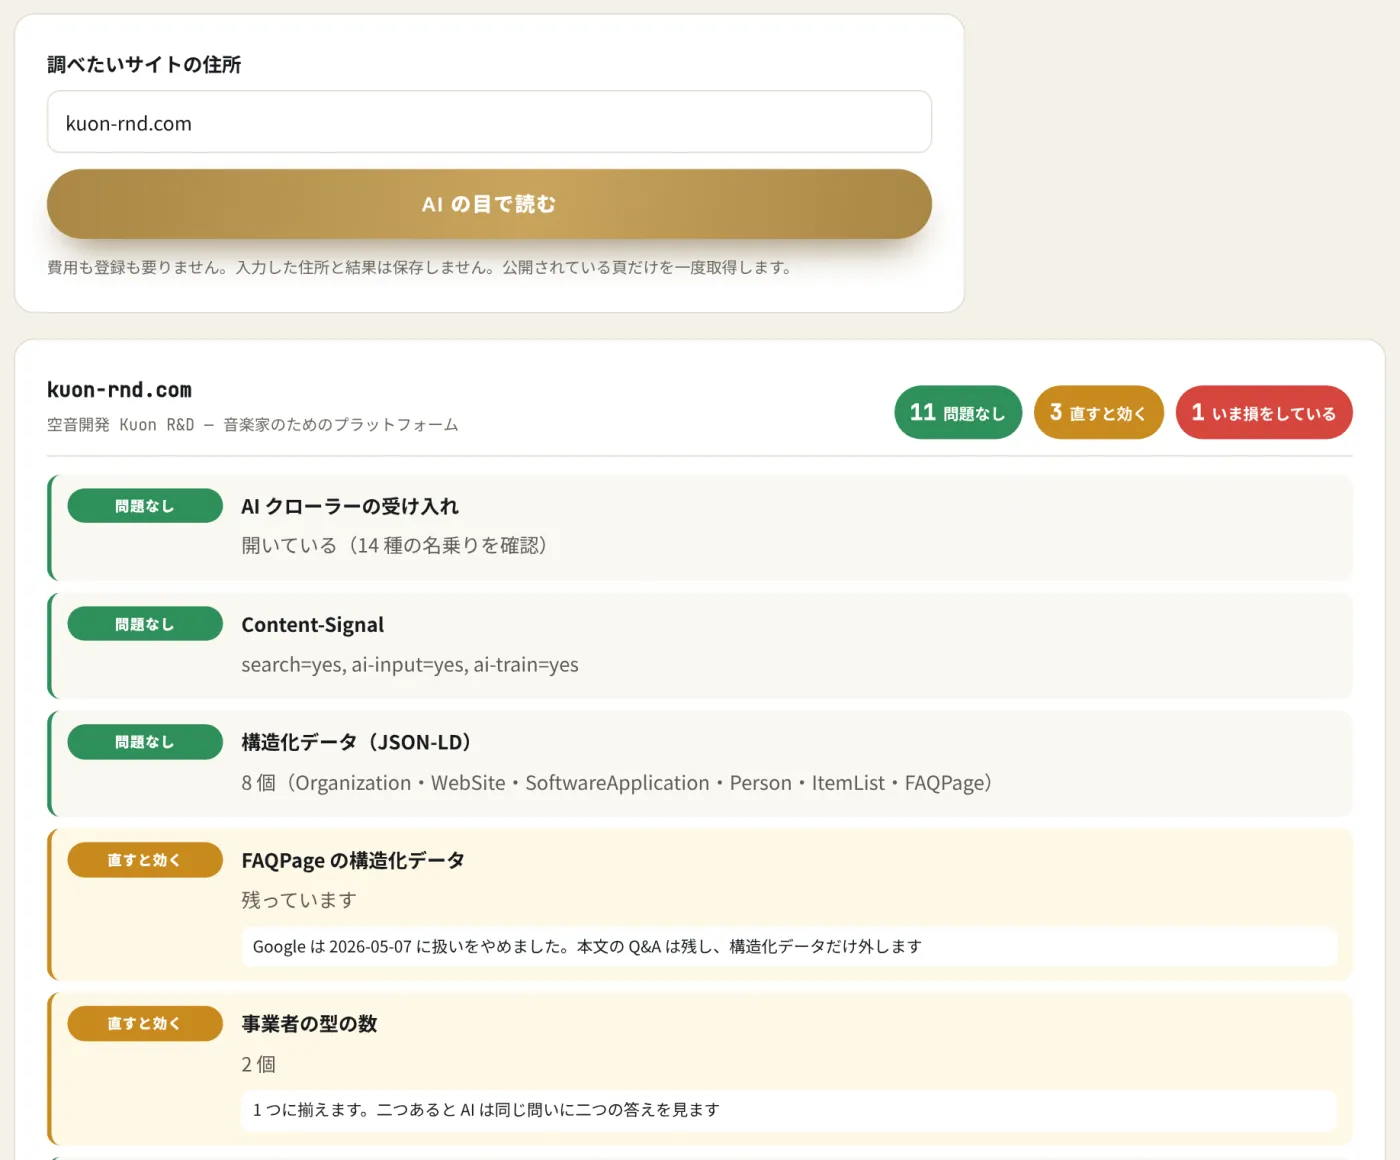
できた文字を、サイトの一番上の階層に robots.txt という名前で置きます(例 https://example.co.jp/robots.txt)。置いたあとは、上の道具「AI にはこう見える」で読めているか確かめられます。
LIST
名前は、各社が公開している名乗り(User-agent)です。「何のために来るか」は各社の公開文書の記述を当方が 4 つに分けました。回数は、当方が運営する 6 サイトの配信の入口で数えた 7 日間(2026年9月15日から9月21日)の実測です。推計ではありません。
| 名乗り | 運営 | 何のために来るか | 7 日の来訪(6 サイト) | 説明 |
|---|---|---|---|---|
GPTBot | OpenAI | 学習のため | 10 位以下 | ChatGPT の基盤モデルの学習に使われることがある 公式の文書 ↗ |
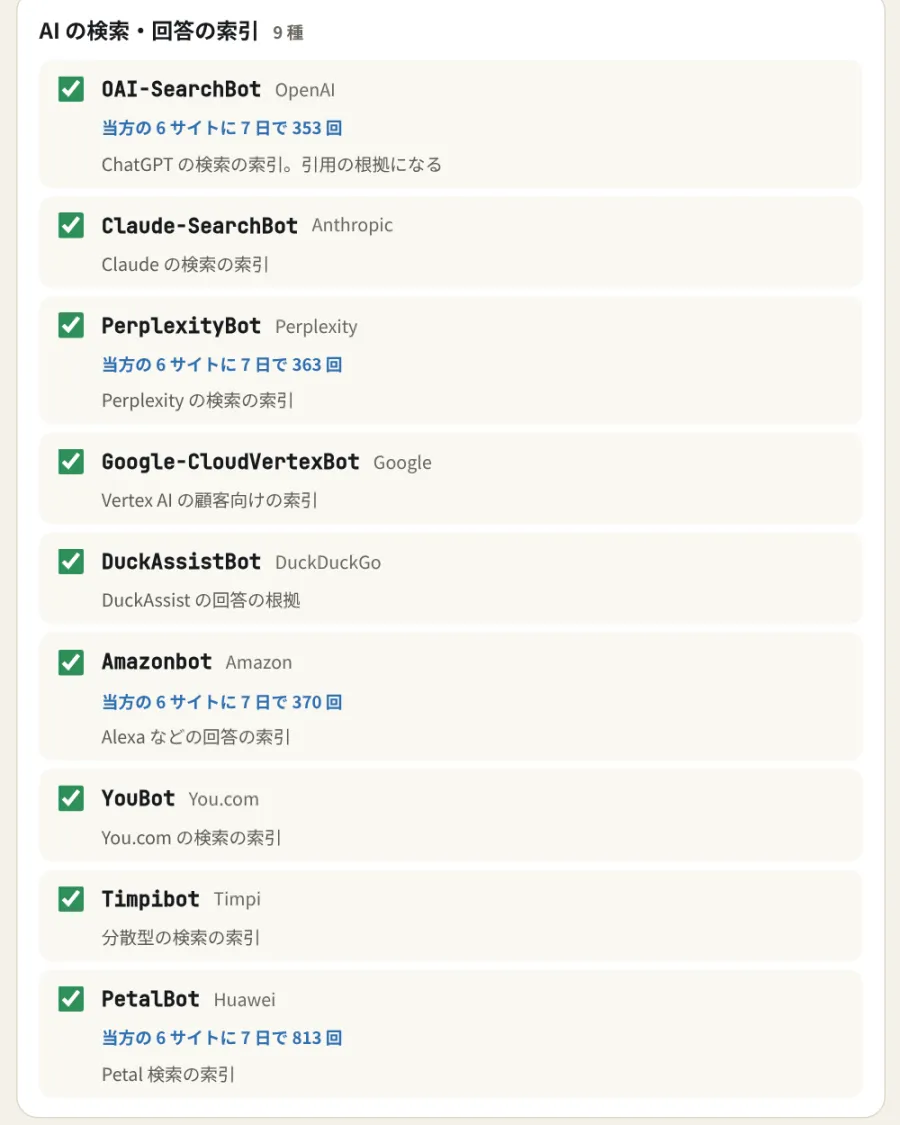
OAI-SearchBot | OpenAI | AI の検索・回答の索引 | 353 | ChatGPT の検索の索引。引用の根拠になる 公式の文書 ↗ |
ChatGPT-User | OpenAI | 人の指示でその場で取りに来る | 320 | 人が ChatGPT で頁を開いたときにその場で取りに来る 公式の文書 ↗ |
ClaudeBot | Anthropic | 学習のため | 1,817 | Claude のモデルの学習と改善のための収集 公式の文書 ↗ |
Claude-SearchBot | Anthropic | AI の検索・回答の索引 | 10 位以下 | Claude の検索の索引 公式の文書 ↗ |
Claude-User | Anthropic | 人の指示でその場で取りに来る | 10 位以下 | 人が Claude で頁を開いたときにその場で取りに来る 公式の文書 ↗ |
anthropic-ai | Anthropic | 学習のため | 10 位以下 | 以前の名乗り。古い robots.txt に残っていることがある |
PerplexityBot | Perplexity | AI の検索・回答の索引 | 363 | Perplexity の検索の索引 公式の文書 ↗ |
Perplexity-User | Perplexity | 人の指示でその場で取りに来る | 10 位以下 | 人が Perplexity で頁を開いたときにその場で取りに来る 公式の文書 ↗ |
Google-Extended | 学習のため | 10 位以下 | Gemini の学習と根拠づけの制御。Google 検索の順位には影響しない 公式の文書 ↗ | |
Google-CloudVertexBot | AI の検索・回答の索引 | 10 位以下 | Vertex AI の顧客向けの索引 公式の文書 ↗ | |
GoogleOther | 従来の検索の土台・その他 | 10 位以下 | 研究や開発のための汎用の取得 公式の文書 ↗ | |
Googlebot | 従来の検索の土台・その他 | 524 | 従来の検索。AI 概要と AI モードの土台。閉じると検索から消える 公式の文書 ↗ | |
bingbot | Microsoft | 従来の検索の土台・その他 | 1,539 | 従来の検索。Copilot と ChatGPT の検索の土台。閉じると両方から消える 公式の文書 ↗ |
DuckAssistBot | DuckDuckGo | AI の検索・回答の索引 | 10 位以下 | DuckAssist の回答の根拠 公式の文書 ↗ |
MistralAI-User | Mistral AI | 人の指示でその場で取りに来る | 10 位以下 | 人が Le Chat で頁を開いたときにその場で取りに来る |
Meta-ExternalAgent | Meta | 学習のため | 618 | Meta の AI の学習と改善のための収集 公式の文書 ↗ |
Meta-ExternalFetcher | Meta | 人の指示でその場で取りに来る | 10 位以下 | 人の指示でその場で取りに来る 公式の文書 ↗ |
Applebot-Extended | Apple | 学習のため | 10 位以下 | Apple の基盤モデルの学習の制御。Applebot 本体(検索)とは別 公式の文書 ↗ |
Amazonbot | Amazon | AI の検索・回答の索引 | 370 | Alexa などの回答の索引 公式の文書 ↗ |
Bytespider | ByteDance | 学習のため | 1,447 | TikTok の親会社の収集。robots.txt を守らない報告が多い |
CCBot | Common Crawl | 学習のため | 10 位以下 | 公開の巨大な収集。多くのモデルの学習の元になっている 公式の文書 ↗ |
cohere-ai | Cohere | 学習のため | 10 位以下 | Cohere のモデルの学習 |
YouBot | You.com | AI の検索・回答の索引 | 10 位以下 | You.com の検索の索引 公式の文書 ↗ |
Diffbot | Diffbot | 従来の検索の土台・その他 | 10 位以下 | 構造化した知識グラフの収集 |
Timpibot | Timpi | AI の検索・回答の索引 | 10 位以下 | 分散型の検索の索引 |
PetalBot | Huawei | AI の検索・回答の索引 | 813 | Petal 検索の索引 |
HOW TO WRITE
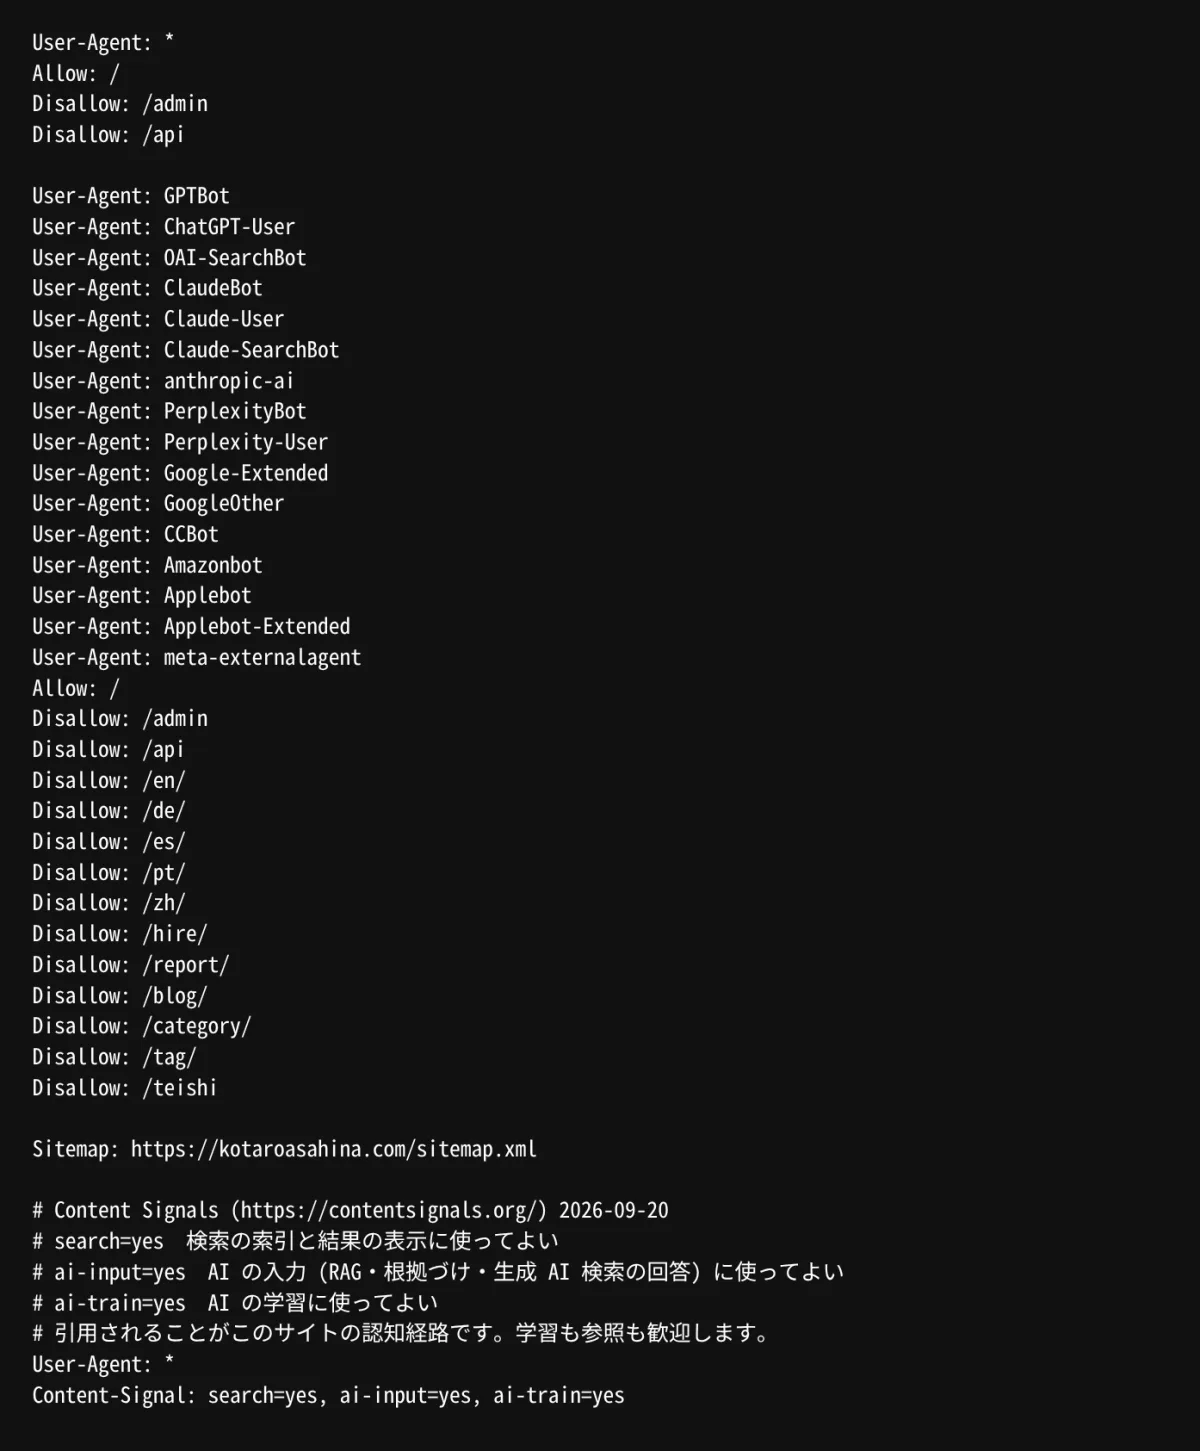
robots.txt は、サイトの一番上に置く文字のファイルです。User-agent に名乗りを書き、Disallow: / で「読ませない」、Allow: / で「読んでよい」を伝えます。学習だけ断りたいなら、GPTBot・ClaudeBot・Google-Extended・CCBot などを Disallow にし、OAI-SearchBot・Claude-SearchBot・PerplexityBot は Allow のままにします。上の道具の「学習だけ断り、検索と回答には読ませる」がその形です。Googlebot と bingbot を Disallow にすると、AI からだけでなく従来の検索からも消えます。robots.txt は「お願い」です。守らない収集者(Bytespider など)には効きません。それを止めるには配信側での遮断が要ります。
GPTBot とは、OpenAI が ChatGPT の基盤モデルの学習のために使う名乗りです。ChatGPT の検索の索引は OAI-SearchBot、人が ChatGPT で頁を開くときは ChatGPT-User と、三つに分かれています。
CONTENT-SIGNAL
robots.txt に一行で書く、内容の使い方の意思表示です。search(検索の索引と表示)、ai-input(AI の回答の根拠にすること)、ai-train(AI の学習に使うこと)の三つに yes か no を書きます。書かない場合は unknown の扱いで、意思が伝わりません。当方の 6 サイトは三つとも yes にしています。AI に引かれることが売上に直結するからです。これは法律の効力を持つものではなく、読む側が守ることを期待した表示です。守らない収集者もいます。
DECIDE
BASICS
AI クローラーとは、ChatGPT・Claude・Gemini・Perplexity などを運営する会社が、ウェブの頁を自動で取りに来るときの仕組みと、その名乗り(User-agent)のことです。従来の検索のクローラー(Googlebot・bingbot)と違うのは、目的が三つに分かれていることです。モデルの学習のため、AI の検索と回答の索引のため、人の指示でその場で取りに来るため。同じ会社でも名乗りを分けています。OpenAI なら GPTBot(学習)、OAI-SearchBot(検索の索引)、ChatGPT-User(人の指示)の三つです。当方の 6 サイトでは、7 日間に 10,008 回の来訪がありました。最も多いのは ClaudeBot、次に bingbot、Bytespider です。学習のための収集が、検索のための収集より多い、というのが実測です。
SYNTAX
SPEC
Content-Signal は、Cloudflare が 2025 年 9 月 24 日に公開した、robots.txt に一行で書く意思表示です。三つの信号に yes か no を書きます。search は検索の索引と表示に使ってよいか、ai-input は AI の回答の根拠(引用・要約・AI 概要)に使ってよいか、ai-train は AI の学習に使ってよいか。書き方は Content-Signal: search=yes, ai-input=yes, ai-train=no のように、カンマで区切ります。書かなかった信号は「表明なし」で、yes とも no とも取られません。robots.txt の User-agent や Disallow とは独立していて、両方を書けます。Cloudflare が管理する robots.txt を使うサイト(発表時に 380 万ドメイン)には、既定で search=yes, ai-train=no が入り、ai-input は表明なしになっています。つまり、いま多くのサイトは「知らないうちに学習を断っている」状態です。自分のサイトの robots.txt を開いて確かめる価値があります。これは標準ではありません。IETF の AIPREF という作業部会が、AI の利用の意思表示の標準化を進めていて、決まるまでは Content-Signal と AIPREF の両方を書くと矛盾を作るおそれがあります。当方は Content-Signal だけを書いています。法律上の効力はなく、読む側が守ることを期待した表示です。守らない収集者には、次の節の方法が要ります。
BEYOND
EACH
名前で検索して来た方のために、一つずつ置きます。回数は当方の 6 サイトへの 7 日間(2026年9月15日から9月21日)の実測です。
GPTBotOpenAI学習のため。ChatGPT の基盤モデルの学習に使われることがある。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: GPTBot Disallow: /
OAI-SearchBotOpenAIAI の検索・回答の索引。ChatGPT の検索の索引。引用の根拠になる。当方の 6 サイトへ 7 日で 353 回。 公式の文書 ↗
User-agent: OAI-SearchBot
Disallow: /
ChatGPT-UserOpenAI人の指示でその場で取りに来る。人が ChatGPT で頁を開いたときにその場で取りに来る。当方の 6 サイトへ 7 日で 320 回。 公式の文書 ↗
User-agent: ChatGPT-User
Disallow: /
ClaudeBotAnthropic学習のため。Claude のモデルの学習と改善のための収集。当方の 6 サイトへ 7 日で 1,817 回。 公式の文書 ↗
User-agent: ClaudeBot
Disallow: /
Claude-SearchBotAnthropicAI の検索・回答の索引。Claude の検索の索引。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: Claude-SearchBot
Disallow: /
Claude-UserAnthropic人の指示でその場で取りに来る。人が Claude で頁を開いたときにその場で取りに来る。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: Claude-User
Disallow: /
anthropic-aiAnthropic学習のため。以前の名乗り。古い robots.txt に残っていることがある。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。
User-agent: anthropic-ai
Disallow: /
PerplexityBotPerplexityAI の検索・回答の索引。Perplexity の検索の索引。当方の 6 サイトへ 7 日で 363 回。 公式の文書 ↗
User-agent: PerplexityBot
Disallow: /
Perplexity-UserPerplexity人の指示でその場で取りに来る。人が Perplexity で頁を開いたときにその場で取りに来る。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: Perplexity-User
Disallow: /
Google-ExtendedGoogle学習のため。Gemini の学習と根拠づけの制御。Google 検索の順位には影響しない。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: Google-Extended
Disallow: /
Google-CloudVertexBotGoogleAI の検索・回答の索引。Vertex AI の顧客向けの索引。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: Google-CloudVertexBot
Disallow: /
GoogleOtherGoogle従来の検索の土台・その他。研究や開発のための汎用の取得。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: GoogleOther
Disallow: /
GooglebotGoogle従来の検索の土台・その他。従来の検索。AI 概要と AI モードの土台。閉じると検索から消える。当方の 6 サイトへ 7 日で 524 回。 公式の文書 ↗
User-agent: Googlebot
Disallow: /
bingbotMicrosoft従来の検索の土台・その他。従来の検索。Copilot と ChatGPT の検索の土台。閉じると両方から消える。当方の 6 サイトへ 7 日で 1,539 回。 公式の文書 ↗
User-agent: bingbot
Disallow: /
DuckAssistBotDuckDuckGoAI の検索・回答の索引。DuckAssist の回答の根拠。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: DuckAssistBot
Disallow: /
MistralAI-UserMistral AI人の指示でその場で取りに来る。人が Le Chat で頁を開いたときにその場で取りに来る。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。
User-agent: MistralAI-User
Disallow: /
Meta-ExternalAgentMeta学習のため。Meta の AI の学習と改善のための収集。当方の 6 サイトへ 7 日で 618 回。 公式の文書 ↗
User-agent: Meta-ExternalAgent
Disallow: /
Meta-ExternalFetcherMeta人の指示でその場で取りに来る。人の指示でその場で取りに来る。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: Meta-ExternalFetcher
Disallow: /
Applebot-ExtendedApple学習のため。Apple の基盤モデルの学習の制御。Applebot 本体(検索)とは別。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: Applebot-Extended
Disallow: /
AmazonbotAmazonAI の検索・回答の索引。Alexa などの回答の索引。当方の 6 サイトへ 7 日で 370 回。 公式の文書 ↗
User-agent: Amazonbot
Disallow: /
BytespiderByteDance学習のため。TikTok の親会社の収集。robots.txt を守らない報告が多い。当方の 6 サイトへ 7 日で 1,447 回。
User-agent: Bytespider
Disallow: /
CCBotCommon Crawl学習のため。公開の巨大な収集。多くのモデルの学習の元になっている。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: CCBot
Disallow: /
cohere-aiCohere学習のため。Cohere のモデルの学習。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。
User-agent: cohere-ai
Disallow: /
YouBotYou.comAI の検索・回答の索引。You.com の検索の索引。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。 公式の文書 ↗
User-agent: YouBot
Disallow: /
DiffbotDiffbot従来の検索の土台・その他。構造化した知識グラフの収集。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。
User-agent: Diffbot
Disallow: /
TimpibotTimpiAI の検索・回答の索引。分散型の検索の索引。当方の 6 サイトへの 7 日の来訪は上位 10 に入らず。
User-agent: Timpibot
Disallow: /
PetalBotHuaweiAI の検索・回答の索引。Petal 検索の索引。当方の 6 サイトへ 7 日で 813 回。
User-agent: PetalBot
Disallow: /
VERIFY
Q&A
SOURCES
各社の名乗りと目的は、上の表の「公式の文書」から。Content-Signal の書き方は Cloudflare が 2025 年 9 月に公開した仕様に沿っています。来訪の回数は当方の 6 サイト(kotaroasahina.com・kuon-rnd.com・tango.blue・kuongeo.com・curanzsounds.com・kazokunomado.com)の記録で、月に一度更新します。
Cloudflare「Content Signals Policy」(2025年9月24日)↗ contentsignals.org(仕様の原文)↗ Google 検索セントラル「robots.txt の仕様」↗ IETF AIPREF 作業部会 ↗(取得 2026年9月21日)